Bezpieczeństwo danych w AI: dlaczego model nie powinien widzieć wszystkiego
Minimalizacja danych, uprawnienia, anonimizacja, prywatne środowiska i audyt w praktycznym projekcie AI dla firmy.
Wdrożenie AI nie oznacza wysyłania całej firmy do modelu
Model potrzebuje kontekstu, ale nie potrzebuje dostępu do wszystkiego. System przygotowujący odpowiedź dotyczącą jednego zamówienia nie musi otrzymywać pełnej historii wszystkich klientów. Narzędzie podsumowujące fragment umowy nie powinno automatycznie przetwarzać całego repozytorium dokumentów.
Bezpieczny projekt zaczyna się od pytania, jaki minimalny zestaw informacji jest potrzebny do wykonania zadania. Dopiero później wybiera sposób przekazania tych danych, środowisko przetwarzania i mechanizmy kontroli. Dostęp do większej liczby źródeł nie zawsze poprawia jakość. Często zwiększa szum, koszt i ryzyko ujawnienia informacji.
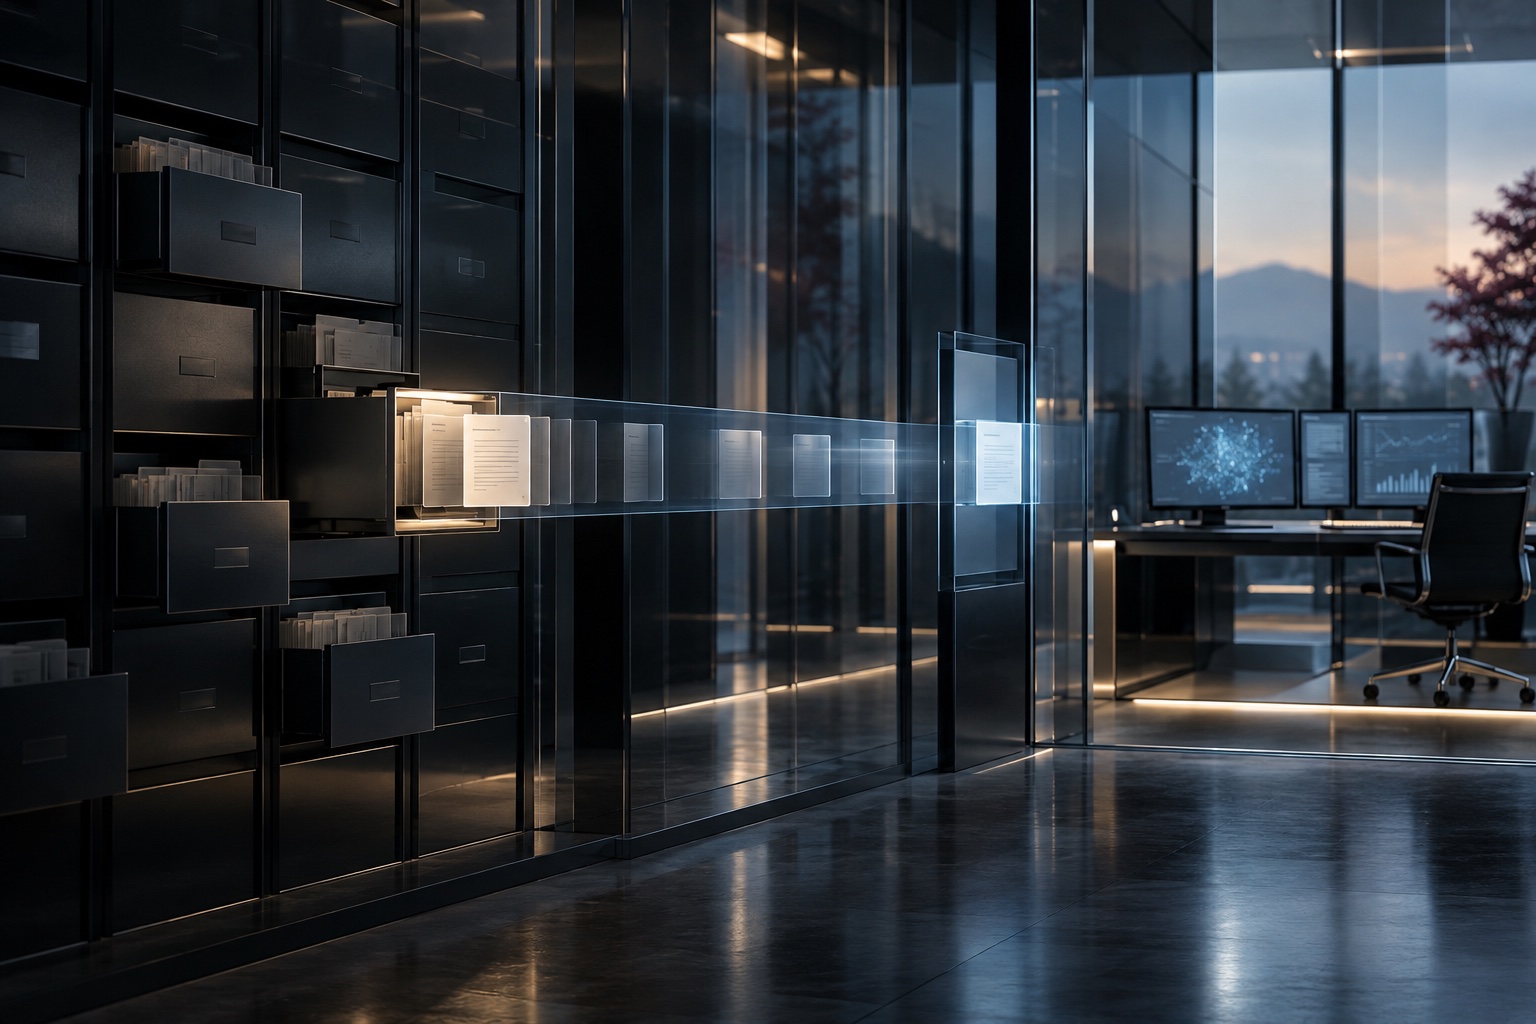
Zasada jest prosta: model otrzymuje właściwy fragment danych we właściwym momencie, dla uprawnionego użytkownika i w celu opisanym przez proces. Nie budujemy jednego nieograniczonego okna do całej organizacji.
Najpierw mapa danych i odpowiedzialności
Przed integracją należy ustalić, gdzie znajdują się dane, kto jest ich właścicielem, które informacje są poufne i jak długo powinny być przechowywane. Ta mapa obejmuje nie tylko bazy i dokumenty. Trzeba uwzględnić skrzynki pocztowe, komunikatory, historię zapytań, logi oraz dane tworzone przez sam system.
Ważne jest rozróżnienie między danymi źródłowymi a treścią wygenerowaną. Odpowiedź modelu nie staje się automatycznie nowym źródłem prawdy. Powinna wskazywać dokument lub rekord, z którego wynikają kluczowe informacje, oraz datę ich aktualności.
Każde źródło powinno mieć właściciela odpowiedzialnego za jakość i dostęp. Jeśli nie wiadomo, kto może potwierdzić aktualność dokumentu, problem nie jest wyłącznie techniczny. System AI jedynie ujawni brak odpowiedzialności, który istniał wcześniej.
Minimalizacja danych w praktyce
Minimalizacja oznacza, że proces pobiera tylko pola i fragmenty niezbędne do zadania. Zamiast przesyłać cały profil klienta, może pobrać identyfikator sprawy, kategorię produktu i status zamówienia. Zamiast pełnej umowy, może przekazać właściwy paragraf wraz z definicjami potrzebnymi do jego interpretacji.
Wyszukiwanie kontekstowe powinno działać przed wywołaniem modelu. System ustala uprawnienia użytkownika, odnajduje dozwolone materiały, wybiera kilka trafnych fragmentów i dopiero wtedy buduje zapytanie. Model nie przeszukuje samodzielnie wszystkich zasobów i nie decyduje, które ograniczenia dostępu pominąć.
Minimalizacja poprawia również jakość. Mniejszy, trafniejszy kontekst ogranicza sprzeczności i ułatwia wskazanie źródła. Bezpieczeństwo i użyteczność nie muszą być przeciwstawnymi celami.
Anonimizacja i pseudonimizacja nie są tym samym
Usunięcie imienia z dokumentu nie zawsze oznacza, że osoba przestała być możliwa do rozpoznania. Kombinacja stanowiska, lokalizacji, daty i nietypowego zdarzenia może nadal prowadzić do identyfikacji. Dlatego zakres przekształcenia danych powinien wynikać z celu i ryzyka, a nie z jednego mechanicznego filtra.
Pseudonimizacja zastępuje bezpośredni identyfikator inną wartością, ale możliwość ponownego powiązania może nadal istnieć. Anonimizacja wymaga znacznie silniejszej oceny. W praktycznym procesie warto najpierw sprawdzić, czy dane osobowe są w ogóle potrzebne modelowi. Często wystarczy kategoria sprawy, zakres kwotowy lub ogólny opis sytuacji.
Jeżeli identyfikatory są wymagane do wykonania działania, można rozdzielić etapy. Model przygotowuje decyzję lub tekst na danych ograniczonych, a warstwa deterministyczna ponownie łączy wynik z właściwym rekordem w kontrolowanym środowisku.
Model nie może poszerzać uprawnień użytkownika
Użytkownik powinien zobaczyć przez system AI wyłącznie te informacje, do których ma prawo w systemie źródłowym. Warstwa wyszukiwania i integracji musi sprawdzać rolę, organizację, klienta i zakres zadania przed pobraniem treści.
Nie wystarczy poprosić modelu, aby nie ujawniał danych. Ograniczenie powinno być egzekwowane poza modelem. Jeśli pracownik nie może otworzyć dokumentu bezpośrednio, system nie powinien przekazać jego fragmentu do odpowiedzi tylko dlatego, że pytanie zostało sformułowane naturalnym językiem.
W środowiskach wieloklienckich szczególne znaczenie ma izolacja tenantów. Identyfikator organizacji powinien być częścią każdego zapytania do danych, a testy muszą obejmować próby pobrania informacji z innego zakresu.
Chmura, single-tenant, on-premise czy model lokalny
Nie ma jednego właściwego środowiska dla wszystkich zastosowań. Proste zadanie na publicznych materiałach może działać w usłudze chmurowej. Proces wykorzystujący poufne dokumenty, dane klientów lub wiedzę objętą tajemnicą przedsiębiorstwa może wymagać środowiska single-tenant, prywatnej infrastruktury albo modelu lokalnego.
Decyzja powinna uwzględniać miejsce przetwarzania, retencję, warunki dostawcy, sposób użycia danych, możliwość wyłączenia trenowania, szyfrowanie, dostęp administracyjny, kopie zapasowe i procedurę zakończenia usługi. Nazwa modelu jest tylko jednym z elementów tej oceny.
Część procesu można również wykonać lokalnie, a do zewnętrznego modelu przekazać wyłącznie zanonimizowany fragment. Architektura hybrydowa pozwala zachować kontrolę nad danymi źródłowymi i jednocześnie korzystać z możliwości modeli tam, gdzie jest to uzasadnione.
Dokument może zawierać treść próbującą sterować systemem
System analizujący wiadomości, strony internetowe lub dokumenty może zetknąć się z instrukcją, która próbuje zmienić jego zachowanie. Treść źródłowa nie powinna być traktowana jak polecenie administracyjne. Model musi odróżniać zadanie systemu od danych, które analizuje.
Ochrona obejmuje ograniczenie narzędzi, walidację argumentów, filtrowanie wyników, separację danych od instrukcji i akceptację przed operacją o większym wpływie. Model nie powinien móc samodzielnie zdecydować, że treść dokumentu upoważnia go do wysłania wiadomości, pobrania kolejnych danych lub wykonania polecenia w systemie.
Szczególnie ważne są testy obejmujące nietypowe dokumenty, linki, załączniki i próby wywołania niedozwolonych działań. Bezpieczeństwo agenta wymaga kontroli całego łańcucha, a nie tylko oceny pojedynczej odpowiedzi tekstowej.
Retencja, logi i ślad audytowy
Historia zapytań może zawierać dane bardziej wrażliwe niż sama aplikacja. Dlatego trzeba określić, co jest zapisywane, na jak długo, kto ma dostęp i w jaki sposób usuwa się informacje. Pełny prompt nie zawsze musi trafiać do logu. Czasem wystarczy identyfikator sprawy, użyte źródła, wersja reguły i wynik kontroli.
Ślad audytowy powinien umożliwić odtworzenie ważnego działania. Warto zapisać użytkownika, moment uruchomienia, zakres danych, wersję systemu, punkt akceptacji oraz rezultat wykonania. Nie chodzi o gromadzenie wszystkiego bez ograniczeń. Chodzi o zachowanie informacji potrzebnych do wyjaśnienia decyzji i obsługi incydentu.
Retencja musi obejmować także kopie, eksporty i środowiska testowe. Dane usunięte z widoku użytkownika nie powinny pozostawać bezterminowo w pomocniczych zbiorach używanych podczas rozwoju.
Lista kontrolna przed podłączeniem danych do AI
Przed uruchomieniem sprawdź cel przetwarzania, minimalny zakres informacji, właściciela źródła, jakość danych, podstawę dostępu, retencję, środowisko, zasady dostawcy, możliwość anonimizacji, izolację użytkowników, mechanizm odmowy oraz punkt akceptacji człowieka.
Następnie przetestuj brakujące dane, sprzeczne źródła, pytania spoza zakresu, próbę dostępu do niedozwolonej informacji, treść sterującą ukrytą w dokumencie i awarię integracji. Bezpieczny system musi wiedzieć nie tylko, jak odpowiedzieć, ale również kiedy przerwać pracę.
Jak ocenić dostawcę modelu lub platformy
Umowa i dokumentacja powinny odpowiadać na pytania o miejsce przetwarzania, retencję, wykorzystanie danych do trenowania, podwykonawców, szyfrowanie, kontrolę administracyjną, eksport i usuwanie. Ważne są także mechanizmy pozwalające ograniczyć logowanie oraz ustawić oddzielne środowiska testowe i produkcyjne.
Deklaracja, że dane są bezpieczne, nie zastępuje konkretnego opisu przepływu. Trzeba wiedzieć, które informacje opuszczają środowisko firmy, gdzie trafiają, jak długo pozostają dostępne i kto może uzyskać do nich dostęp w sytuacji wsparcia technicznego.
Ocena dostawcy nie kończy się w dniu zakupu. Warunki, modele, regiony i funkcje mogą się zmieniać. Organizacja powinna okresowo sprawdzać konfigurację oraz dokumentować decyzje dotyczące nowych funkcji, zanim zostaną udostępnione użytkownikom.
Środowiska testowe też wymagają ochrony
Podczas pilotażu zespoły często kopiują dane produkcyjne do arkusza lub demonstracyjnej bazy, aby szybciej zbudować prototyp. W ten sposób najbardziej wrażliwe informacje mogą trafić do środowiska z gorszą kontrolą dostępu, krótszą historią zmian i niejasną retencją.
Testy powinny w pierwszej kolejności korzystać z danych syntetycznych albo odpowiednio przygotowanych zestawów. Jeśli potrzebne są przypadki rzeczywiste, zakres należy ograniczyć, usunąć niepotrzebne identyfikatory i określić termin usunięcia kopii.
Oddzielenie środowisk zapobiega również przypadkowemu wykonaniu działania na realnym kliencie. Integracje testowe nie powinny wysyłać wiadomości, zmieniać produkcyjnych rekordów ani korzystać z pełnych uprawnień konta administracyjnego.
Co zrobić, gdy system ujawni niewłaściwą informację
Plan reakcji powinien istnieć przed uruchomieniem. Zespół musi wiedzieć, jak zatrzymać funkcję, ograniczyć dostęp, zabezpieczyć logi, ustalić zakres zdarzenia i powiadomić osoby odpowiedzialne. Szybkość reakcji zależy od tego, czy system pozostawia wystarczający ślad do odtworzenia działania.
Po incydencie trzeba usunąć nie tylko widoczny skutek, ale także przyczynę. Może nią być zbyt szerokie zapytanie do bazy, brak filtra tenantów, niewłaściwa konfiguracja uprawnień albo zapis pełnych promptów. Wnioski powinny trafić do testów regresyjnych, aby podobna sytuacja nie pojawiła się ponownie.
Pracownicy powinni mieć prosty sposób zgłaszania podejrzanej odpowiedzi. Ukrywanie niepewności powoduje, że błędy pozostają niewidoczne do momentu, gdy zobaczy je klient lub osoba nieuprawniona.
Najczęstsze pytania o bezpieczeństwo danych w AI
Czy wszystkie dane trzeba anonimizować? Nie zawsze, ale model powinien otrzymywać tylko informacje niezbędne do celu. Jeżeli identyfikator nie wpływa na wynik, najlepiej usunąć go przed przetwarzaniem. Jeśli jest potrzebny, trzeba kontrolować dostęp oraz środowisko.
Czy prywatny model automatycznie rozwiązuje problem bezpieczeństwa? Nie. Nadal potrzebne są uprawnienia, jakość źródeł, retencja, logi, testy i kontrola wykonywanych działań. Lokalizacja modelu jest ważna, ale stanowi tylko jeden element architektury.
Czy można bezpiecznie używać AI z dokumentami firmowymi? Tak, jeżeli proces ogranicza zakres danych, sprawdza uprawnienia, kontroluje dostawcę lub środowisko, wskazuje źródła i przewiduje odmowę w sytuacji braku pewności.
Bezpieczeństwo danych jest elementem projektu, nie dodatkiem
Najskuteczniejszą ochroną nie jest ostrzeżenie umieszczone obok pola tekstowego. Jest nią architektura, która ogranicza dostęp jeszcze przed wywołaniem modelu, przekazuje minimalny kontekst, oddziela reguły od generowania i wymaga zatwierdzenia tam, gdzie konsekwencje są istotne.
Firma nie musi wybierać między bezpieczeństwem a wykorzystaniem AI. Może zaprojektować proces tak, aby model widział tylko to, czego potrzebuje, a dane źródłowe, uprawnienia i wykonanie działania pozostawały pod kontrolą organizacji.
Źródła
Powiązane materiały
Agent AI w firmie: co może zrobić sam, a co wymaga akceptacji ↗
Czy Twoja firma jest gotowa na AI? 12 pytań przed pierwszym wdrożeniem ↗
Nie wszystko powinno robić AI. Co automatyzować deterministycznie? ↗
Przełóż ten temat na sytuację Twojej firmy.
Pierwsza rozmowa jest bezpłatna. Ustalimy proces, obecne systemy i decyzję, którą trzeba podjąć.
Porozmawiajmy ↗